物流大数据处理服务 架构设计与应用实践
一、物流大数据的特点与处理挑战
物流行业每天产生海量数据,涵盖订单信息、运单轨迹、仓储进出库记录、车辆GPS定位、配送签收、异常事件等。这些数据具有典型的"5V"特征:数据量大、类型多样、产生速度快、价值密度低、真实性要求高。传统的数据处理方式已难以应对日均千万级运单、亿级轨迹点的高并发写入与实时分析需求,亟需构建专业化的物流大数据处理服务体系。
二、物流大数据处理服务的总体架构
一个完整的物流大数据处理服务通常采用分层架构:
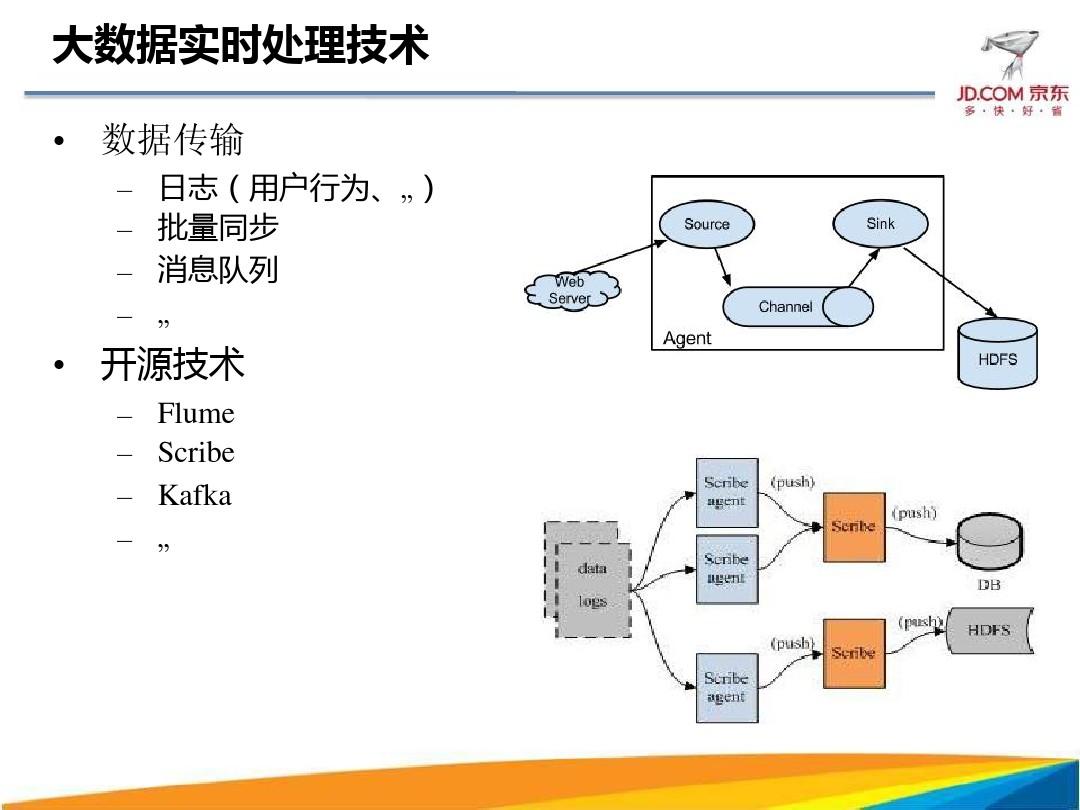
- 数据接入层:负责多源异构数据的统一采集。通过消息队列(如Kafka)对接业务系统数据库(CDC变更捕获)、车载终端、手持PDA、IoT传感器等,实现实时流数据与批量数据的统一接入。
- 数据存储层:根据数据热度采用分级存储策略。实时轨迹与订单流数据存入分布式消息队列与时序数据库;明细数据落地数据湖(如HDFS或对象存储);结构化汇总数据存入分布式数据仓库(如ClickHouse、Doris),支撑高并发查询。
- 数据计算层:构建批流一体的计算引擎体系。流式计算(如Flink)负责实时轨迹解析、电子围栏判断、时效预警;批处理(如Spark)负责历史数据清洗、路径还原与指标汇总;即席查询引擎支撑运营人员的交互式分析。
- 数据服务层:将处理结果封装为标准API或数据产品,向上层应用(如运输管理系统、仓储管理系统、客户查询平台、管理驾驶舱)提供统一的数据服务能力。
- 数据治理与运维层:贯穿全链路的数据质量监控、元数据管理、血缘追踪、权限控制与任务调度,保障数据处理服务的稳定与可信。
三、核心数据服务能力
基于上述架构,物流大数据处理服务通常对外提供以下几类核心能力:
(1)实时轨迹处理服务:对GPS/北斗定位数据进行实时去噪、抽稀、纠偏与路网匹配,支撑在途可视化与到达时间预测。
(2)订单全链路状态服务:整合下单、揽收、中转、派送、签收各环节事件,构建统一的订单状态机,对外提供一致的状态查询接口。
(3)时效分析与预警服务:基于历史时效数据建立分线路、分时段的时效基线,实时识别超时风险并触发预警。
(4)仓储作业分析服务:对出入库、库内作业、库存周转等数据进行聚合计算,输出库容利用率、作业效率等指标。
(5)数据开放与订阅服务:通过API网关与数据订阅机制,支持下游系统按需获取数据,避免重复建设。
四、关键技术与实施要点
- 数据质量治理:建立字段级校验规则与异常数据回流机制,对轨迹漂移、时间戳错乱、重复上报等问题进行自动识别与修复。
- 实时与批量统一:采用Lambda或Kappa架构思路,尽量复用计算逻辑,降低两套链路带来的口径不一致风险。
- 资源弹性调度:结合容器化与任务优先级调度,保障大促、旺季等峰值场景下的服务稳定性。
- 安全与合规:对涉及用户隐私与商业敏感的数据进行脱敏与分级授权,落实数据全生命周期安全管理。
五、应用价值与展望
专业的物流大数据处理服务能够显著降低各业务系统的数据重复建设成本,提升数据一致性与实时性,为智能调度、路径优化、时效承诺、成本核算等上层应用提供坚实的数据底座。随着湖仓一体、流批融合与AI增强分析技术的成熟,物流大数据处理服务将朝着更实时、更智能、更易用的方向持续演进,成为物流企业数字化运营的核心基础设施。
如若转载,请注明出处:http://www.sqhljc.com/product/51.html
更新时间:2026-10-24 08:29:12